一个视频,
不止一种理解。
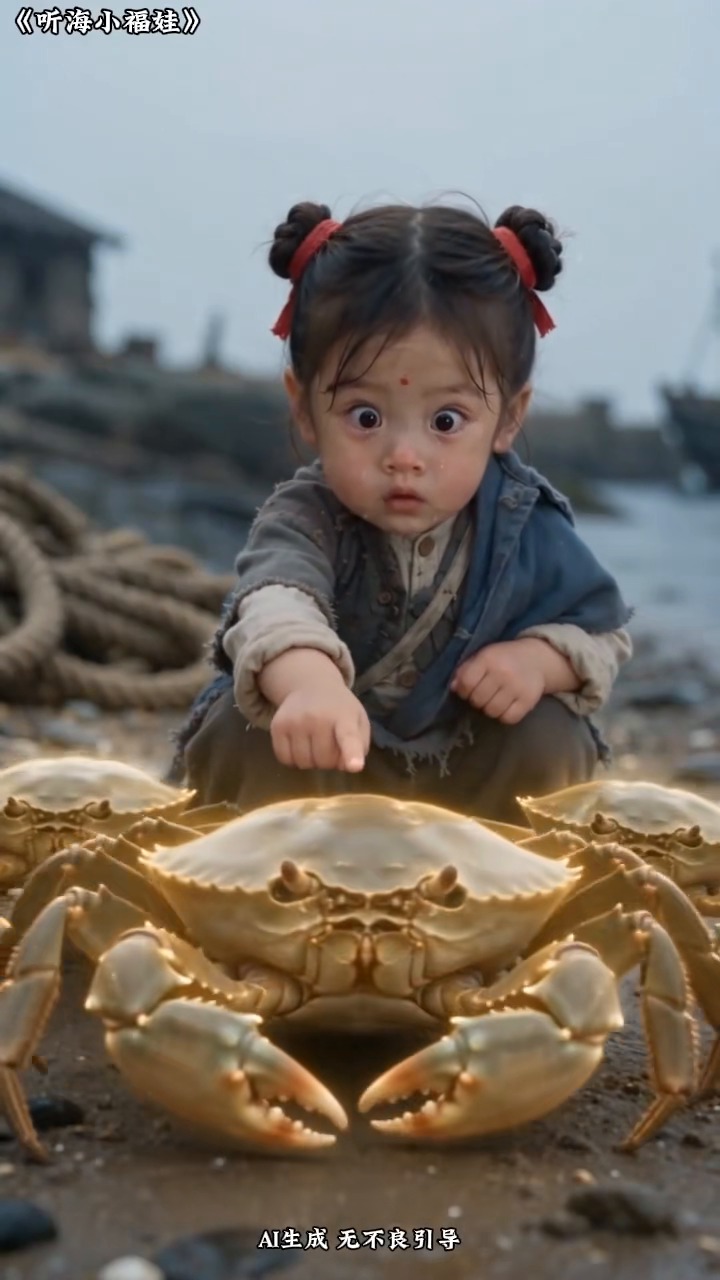
从《听海小福娃》的每一帧出发,
对照模型原文,探索新的故事。
听海小福娃
视频反推实验室
把画面覆盖、视觉识别、提示词组织和二次创作分开看。每份原始输出都保留;流畅的描述与正确的描述,需要分别检验。
先看原视频,再看懂这个故事
人物、道具、情绪与转折,24 个叙事段落逐一拆开。
 02
84 张,真的够看懂全片吗?
多一张画面,可能补到关键瞬间,也可能带入新的误识别。
 03
从一粒米,写出另一片大海
第一秒的视觉钩子,接上人物选择、情绪回报与余味。
先看真实进度
同一段视频,更完整的证据
浏览器预览使用兼容性较好的 H.264 下载版;正式分析使用用户提供的高清版。
| 初次下载 | 用户高清版 | |
|---|---|---|
| 大小 | 27,054,683 字节 25.80 MiB | 56,527,073 字节 53.91 MiB |
| 分辨率 / 编码 | 576×1024 / H.264 | 720×1280 / HEVC |
| 时长 / 帧率 | 约 416.33 秒 / 30 fps | |
展开 24 个宏观叙事段落(不是全部实际切镜)
84 张够吗?三个密度的实际差别
同一高清源、同一 400 帧母集,选取 84 / 200 / 400 帧;同一 BLIP 模型逐帧描述,再用同一 Qwen3-0.6B 组织提示词。逐帧结果缓存复用,避免重复消耗 CPU。
关键瞬间附近,三组实际抽到了什么
每格取该组距目标时刻最近的一张。84帧的5.2秒画面仍有变大的蟹;下列0秒画面仅用于展示它与2.1秒正面揭示镜头的采样距离。
更多帧确实补到了什么
84 帧约 5 秒的画面仍有变大后的蟹;漏掉的是约 2.1 秒的金色巨蟹正面揭示镜头。200 帧补到这一短镜头和更多道具插入画面,仍漏过约 413.2 秒的泥浆喷涌窗口。400 帧保留了这个尾钩,但仍不是逐帧观看。
最初“每 5 秒一张”的 84 帧与本次对照的均匀 84 帧时间点略有不同;两者单独记录,不混用。
更多帧没有自动解决什么
BLIP 把船桨认成枪、没有表达巨蟹的尺度变化,也把结尾泥浆简化成“人站在海滩”。小型摘要模型又出现照抄时间戳、循环字符与截断。信息进入模型,不代表信息进入了正确提示词。
本实验未生成 84 / 200 / 400 帧对应的新视频,所以比较的是证据与文本输出,不是成片相似度。
补充:同样描述,换用已下载的 Gemma 汇总
三组都使用原始 BLIP 描述和同一查询,没有人工改错或清洗描述;同一 Gemma Q4 模型、相同350token上限。用于查看摘要后端的影响,不是新生成视频或额外独立项目。
补充结果:84帧稿沿用了误识别的摩托车与电影海报;200帧稿枚举到上限截断;400帧稿仍复制噪声,把剧情概括成海滩游玩。Gemma比小型Qwen输出更可读,但六份摘要都不能直接作为忠实全片稿。更多帧应先用于补证据,再核对识别错误;这不证明400帧在其他模型上一定更差。详细记录
选择两份结果,并排核对
相同后端的软件入口、不同权重模型、Codex 全片审阅分别标明。原始描述中的错误不会自动删除。
查看模型对照实际使用的 8 张输入,而非完整 400 张

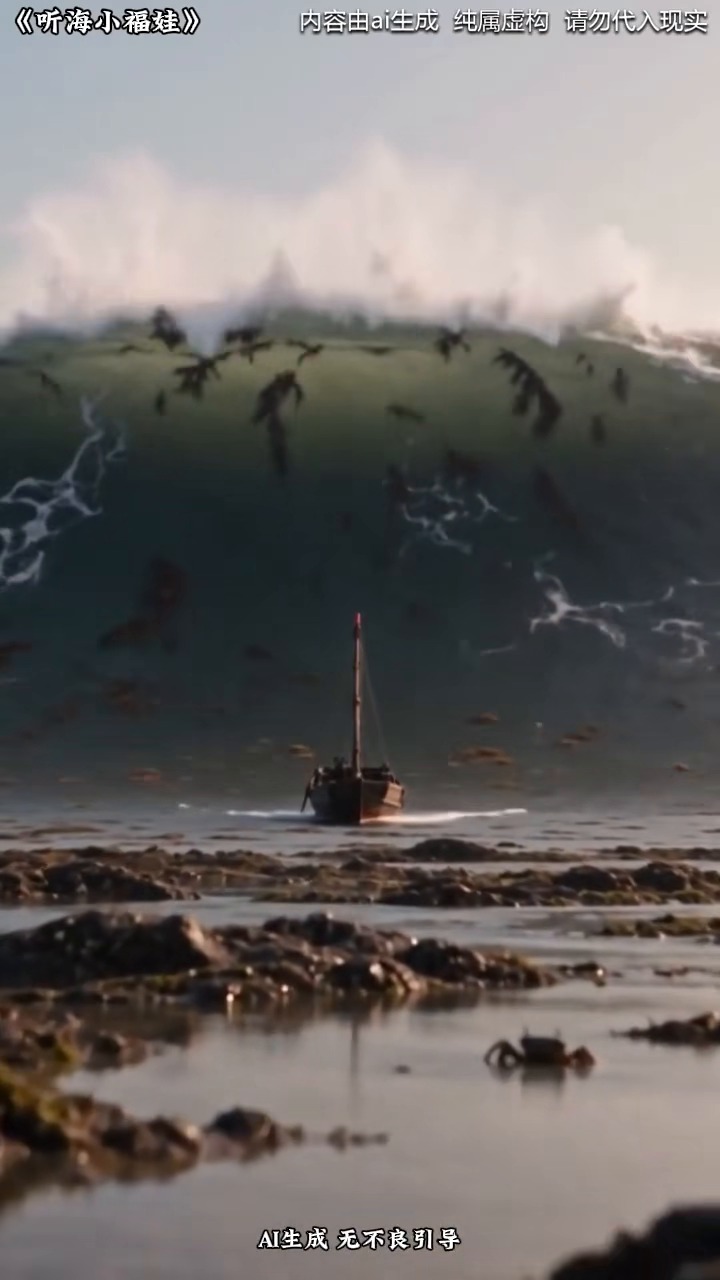
这些输入包含开场螃蟹、哭泣、巨浪、院落木桌、旧书罗盘、人物近景和泥滩收集。没有抽到的情节不作为模型“漏识别”的直接证据。
原始输出,保留错误
主模型对照使用同样的 8 个时间点:0、15、50、95、175、235、340、385 秒,不含音频。不同模型的输入格式和生成接口有差异,细节见各自 JSON。逐帧描述和多图综合描述分开解读。
不同项目也可能输出完全相同
本次 LAVIS、A1111、sd-scripts 的8帧描述逐条一致;原生 Florence 与 TagGUI 的8帧描述也一致。共用权重与解码路径时,换界面或项目入口不会自动增加视觉理解能力。查看文本一致性校验
提示词工作流与可复制文本
下方项目函数试验使用本地模型与8帧输入;随后是 Codex 宿主按开源规则整理的全片稿,以及明确标注的八帧参考稿。全片稿使用更多证据,不能与8帧模型做无条件高低排名。VideoReverse 只运行编译阶段,多个目标格式不等于多个视觉模型。
辅助证据能力
OCR、切镜、物体检测与转录提供证据,本身不是视频反推提示词生成器。
GitHub 项目与环境预检
以下保留导入、依赖和硬件预检记录。安装成功、源码下载成功和模型推理成功是三件不同的事。别名仓库不重复计数;热度按查询时的 stars 展示,小众项目会明确显示。
逐项目测试矩阵与独立记录 · 每个项目目录包含输入查询、真实结果或失败原因。
逐项目真实测试阶段
二次创作 · 独立于原片事实
怎么读这份报告
展开全部方法与已知限制
四类结果不能混在一起
① 本地模型真实推理的原始文字;② 开源工作流配合 Codex 的整理输出;③ OCR、ASR、切镜等辅助证据;④ 仅完成导入或环境检查的项目。没有输出的项目不会被填入伪造的“模型提示词”。
视觉分析使用抽帧,不能可靠恢复原始 seed、生成平台、焦距或完整音轨。反推规格不等于作者原提示词。未做生成视频后的相似度闭环。各运行存在并行负载与 CPU 限制调整,耗时只作这台机器的执行记录,不能直接作为模型速度排行。
平台风格参考及证据边界
TikTok Creative Codes:参考开头钩子、主体、收尾的结构与竖屏制作建议;广告指导不等于有机视频效果保证。
YouTube:Surreal ASMR 趋势:参考不可能材质与声音触感的组合。发布日期为 2025 年 8 月,不冒充实时榜单。
Instagram 创作工具与 Reels:支持探索创意与试验,不证明某一具体剧情必然热门。二创的留存效果需要发布后的真实测试。